A fábrica de código em C: local primeiro, nuvem só quando precisa
11 de outubro de 2026
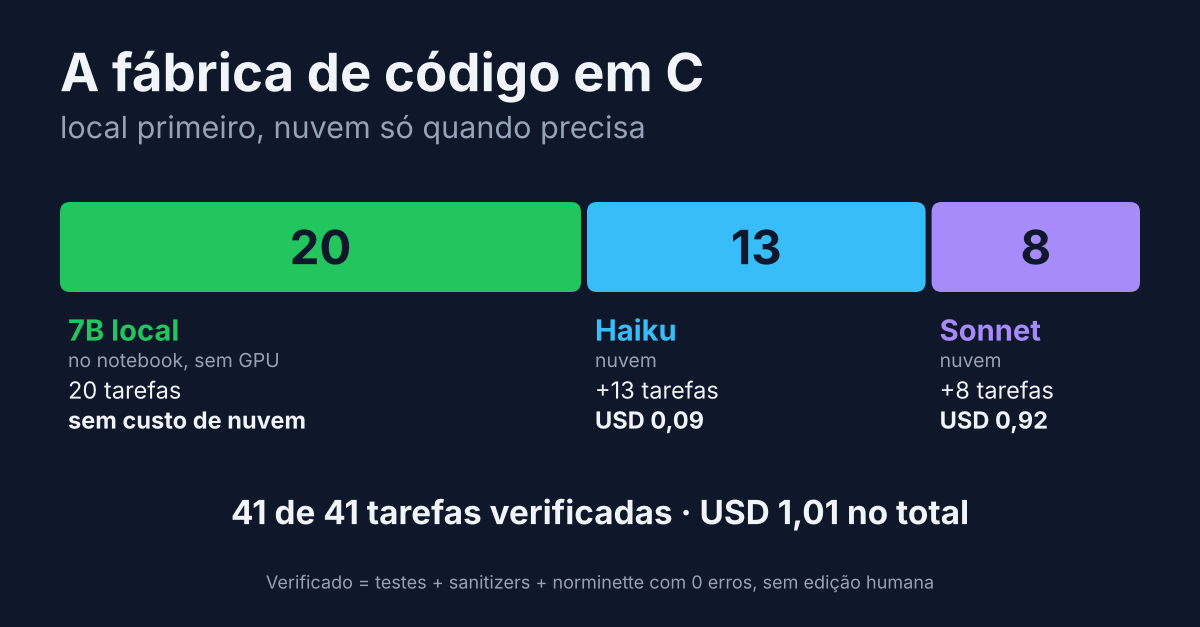
Relatório técnico de Daniel Landi (42 São Paulo, login dlandi), 11/10/2026.
Resumo
Construí um pipeline que escreve pequenas funções em C dentro da Norma da 42, usando primeiro um modelo pequeno no notebook e um modelo pago na nuvem só quando o local falha. Toda resposta é julgada automaticamente, sem nenhuma edição humana.
Numa escada de 41 tarefas (de fáceis a difíceis):
| Sistema | Fáceis + médias (22 tarefas) | Todas as 41 | Custo de nuvem |
|---|---|---|---|
| Qwen2.5-Coder 3B, local | 12 (55%) | 13 de 38 avaliadas | 0 |
| Qwen2.5-Coder 7B, local | 15 (68%) | 20 de 41 (49%) | 0 |
| 7B, depois Claude Haiku 5.5, depois Claude Sonnet 5.5 | não separado | 41 de 41 | USD 1,01 |
- A cascata atingiu a meta (95% ou mais com a nuvem). O nível local não atingiu a sua (80% nas fáceis e médias; o 7B chegou a 68% e continuou em 68% depois que dei 2 tentativas a mais às 7 tarefas que ele não resolveu, 5 no total).
- 21 das 41 tarefas precisaram da nuvem. O Haiku resolveu 13 delas por cerca de 0,7 centavo de dólar cada. O Sonnet resolveu as 8 últimas e levou 91% do dinheiro.
- Cinco experimentos de ajuste no modelo local não deram ganho claro. Um deles parecia sucesso até um controle mostrar o contrário (seção 7).
- Retratei seis afirmações no caminho. Estão listadas na seção 8, porque acho que são a parte mais útil do relatório.
1. O problema e o ambiente
Na 42, todo código em C segue a Norma: funções de no máximo 25 linhas, no máximo 5 funções por arquivo, no máximo 4 parâmetros, sem for, sem switch, sem operador ternário, e mais. Uma ferramenta chamada norminette confere, e um único erro reprova o projeto. O código também precisa estar correto, o que na prática significa testes mais sanitizers (bugs de memória são a forma mais comum de uma função em C “funcionar” e estar errada).
A pergunta: um modelo pequeno no meu notebook consegue escrever código que passe em tudo isso e, se não, de quanta nuvem eu preciso para cobrir o resto?
Hardware: Intel i3-N305, 7,4 GiB de RAM, sem GPU, Pop!_OS. Os modelos locais rodam no llama.cpp (llama-server), quantizados em 4 bits: Qwen2.5-Coder 3B (Q4_K_M) e Qwen2.5-Coder 7B (Q4_K_M, 4,7 GB). Os modelos de nuvem são chamados pela API de Mensagens da Anthropic.
2. O que significa “verificado”
Uma tarefa é verificada quando uma tentativa satisfaz todas as condições abaixo, sem edição humana:
- O código compila com avisos tratados como erros.
- Passa em todos os casos do juiz da tarefa, com AddressSanitizer e UndefinedBehaviorSanitizer ligados.
- Depois de passar pelo
c_formatter_42, a norminette reporta 0 erros.
Cada tarefa tem uma especificação (um arquivo .h), um juiz (um programa de testes), uma solução de referência dentro da Norma e de 3 a 5 versões deliberadamente erradas que o juiz precisa pegar. Os juízes das tarefas que alocam memória também fazem malloc, calloc e realloc falharem de propósito (ligados com --wrap), porque muitas soluções que pareciam certas travavam quando uma alocação falhava.
Uma tentativa tem até 3 rodadas: o modelo escreve o código, o harness roda o juiz e a norminette, e o modelo recebe os erros de volta (saída do compilador, casos que falharam, relatórios dos sanitizers, erros da Norma) e tenta de novo. A melhor rodada de uma tentativa é a que conta. Os resultados locais usam as 3 primeiras tentativas de cada tarefa. Tudo é registrado em um run.json mais o código de cada rodada, então qualquer número deste relatório pode ser recalculado.
3. A escada: 41 tarefas
| Nível | Tarefas | Exemplos |
|---|---|---|
| Fáceis (10) | abs_diff, add, clamp, count_digits, count_words, gcd, is_palindrome, is_power_of_two, min_max, sum_array | um laço ou uma expressão |
| Médias (12) | array_reverse, str_count_substr, array_dup, parse_port, str_interleave, uint_to_binary, str_repeat, str_squeeze, array_rotate, hex_encode e mais duas | alocação, arrays, montagem de strings |
| Difíceis (16) | slist, list_reverse, heap, list_remove_if, queue, vec, mat_mul, map, str_replace_all, str_wrap, base64_encode, base64_decode, format_duration, parse_duration, csv_line_split, calc | estruturas de dados e parsers |
| Outras (3) | trim, rle, stack | as primeiras tarefas que escrevi |
Todas as tarefas foram escritas por mim. Algumas tarefas difíceis foram simplificadas para caber na Norma (por exemplo, o map tem um número fixo de buckets e o heap uma capacidade fixa).
4. Resultados dos modelos locais
| Nível | Tarefas | 3B | 7B |
|---|---|---|---|
| Fáceis | 10 | 8 | 9 |
| Médias | 12 | 4 | 6 |
| Difíceis | 16 | 1 | 4 (slist, list_reverse, heap, vec) |
| Outras | 3 | fora desta comparação | 1 (stack) |
| Fáceis + médias | 22 | 12 (55%) | 15 (68%) |
| Todas | 41 | 13 de 38 avaliadas | 20 de 41 (49%) |
Tentativas verificadas: 55 de 123 para o 7B contra 29 de 114 para o 3B. O 7B resolveu 6 tarefas que o 3B não resolveu, e o 3B não resolveu nenhuma que o 7B errou. As 8 tarefas difíceis de parsing ficaram sem solução nos dois.
Como terminam as tentativas do 7B (melhor rodada de cada uma das 123): 62 passam, 35 com erro de sanitizer, 14 com saída errada, 12 não compilam. Ou seja, a principal perda são bugs de memória e de comportamento indefinido, não a Norma. Dos 104 relatórios de sanitizer, 44 eram heap-buffer-overflow e 25 eram overflow de inteiro com sinal.
Cinco tentativas em vez de três. O critério permite 5 tentativas, então dei às 7 tarefas fáceis e médias que o 7B não resolveu (count_digits, array_unique_sorted, parse_port, str_interleave, str_repeat, str_squeeze, array_rotate) mais duas tentativas cada, com as mesmas configurações e uma meta escrita antes da rodada (18 de 22 = 80%). Resultado: 0 das 14 novas tentativas foi verificada, então o 7B continua em 15 de 22 (68%) e a meta não foi atingida. Somando as 21 tentativas anteriores, são 0 verificadas em 35 tentativas nessas sete tarefas: elas estão além deste modelo, não foram azar. Mais tentativas não fecham a diferença; precisa de um modelo melhor.
O 7B também se repete: em 48% das rodadas de reparo (56 de 116) ele devolveu o mesmo código de antes, a mesma taxa do 3B. O feedback muitas vezes não muda nada.
5. A cascata na nuvem
O 7B falhou em 21 tarefas. Um script mandou exatamente essas para a nuvem em duas etapas, modelo barato primeiro.
| Etapa | Configuração | Tarefas | Resolvidas | Custo |
|---|---|---|---|---|
| Haiku 5.5 | thinking desligado, 3 tentativas, 3 rodadas, teto USD 0,40 | 21 | 13 | USD 0,0866 |
| Sonnet 5.5 | esforço baixo, 2 tentativas, 3 rodadas, teto USD 1,00 | 8 (as que o Haiku errou) | 8 | USD 0,92 |
| Total | 21 | 21 | USD 1,0066 |
- O Haiku resolveu 13 tarefas por cerca de 0,7 centavo cada (
array_rotate,array_unique_sorted,base64_encode,count_digits,list_remove_if,mat_mul,parse_port,queue,str_interleave,str_repeat,str_replace_all,str_squeeze,trim). - O Sonnet resolveu
base64_decode,calc,csv_line_split,format_duration,map,parse_duration,rleestr_wrap, por cerca de 11,5 centavos por tarefa resolvida. - O dinheiro acompanha a dificuldade: as 8 tarefas mais difíceis custaram 91% do gasto na nuvem.
- A contagem de custo do próprio harness bateu com o Console da Anthropic ao centavo. As rodadas de desenvolvimento e exploração antes da cascata final custaram mais ou menos USD 1,8.
Algumas coisas sobre a API que aprendi pelas mensagens de erro: Haiku 5.5 e Sonnet 5.5 rejeitam o parâmetro temperature, então as rodadas na nuvem não são comparáveis diretamente com os 0,2 usados localmente; os tokens de thinking contam para o max_tokens, então um limite baixo pode gerar resposta vazia que parece falha do modelo, mas é limite; e o Sonnet 5.5 recusa thinking: disabled e pede between_tools.
6. Onde o modelo local perde, e onde não perde
- A Norma não é a principal perda. Testei isso diretamente: das 123 tentativas do 7B, só 2 passaram no juiz e tinham apenas erros mecânicos de Norma que um script resolveria. 7 passaram no juiz e falharam na Norma, 5 delas em
TOO_MANY_LINES. - O 7B não tem o hábito do Haiku. O Haiku escreve a lógica correta e depois a divide em funções demais (
TOO_MANY_FUNCS). Esse erro nunca aparece no código do 7B. - O 3B não consegue reestruturar código para caber na Norma, nem com dicas específicas: ao receber a instrução de dividir uma função longa, ele manteve a antiga e acrescentou uma segunda cópia, e o arquivo definia a função duas vezes.
- Feedback específico funciona, e só para o que o modelo consegue ver. Quando o feedback citava a linha com erro e uma reescrita, o 3B corrigia erros de Norma em 1 a 2 rodadas. Um relatório de crash sozinho quase sempre devolvia o mesmo código.
7. Experimentos de ajuste e o controle
Todos no 7B, com as mesmas configurações da escada; uma flag por vez, e a meta de sucesso escrita antes da rodada.
| Experimento | Tarefas | Tentativas verificadas, referência e depois a flag | Resultado |
|---|---|---|---|
--func-budget (dar os limites de funções com números reais) | 12 | 9 de 36, depois 9 de 36 | sem efeito; a premissa estava errada |
--norm-hints2 (citar a linha, dar uma reescrita de for para while) | 12 | 9 de 36, depois 5 de 36 | um pouco pior, dentro da variação entre rodadas |
--sanitizer-hints2 (info de debug, citar a linha com erro, dica por tipo) | 15 | 0 de 45, depois 3 de 45 | parecia sucesso; veja abaixo |
No experimento dos sanitizers usei as 15 tarefas cujas tentativas tinham terminado em erro de sanitizer e fixei três metas antes (pelo menos 3 tentativas verificadas, ou 2 tarefas novas resolvidas, ou terminar em sanitizer 25 vezes ou menos). A primeira rodada cumpriu as três. Anotei como sucesso, e depois rodei um controle: as mesmas configurações, sem a flag, as mesmas tarefas.
| 15 tarefas, 3 tentativas cada | referência | controle (nova rodada, sem flag) | com a flag |
|---|---|---|---|
| Tentativas verificadas | 0 | 0 | 3 |
| Terminaram em erro de sanitizer | 35 | 28 | 25 |
| Passaram no juiz | 1 | 3 | 8 |
| Rodadas de reparo com o mesmo código | não calculado | 51 de 90 | 36 de 90 |
Só o controle já moveu os erros de sanitizer de 35 para 28 e as passagens no juiz de 1 para 3. Eu tinha escolhido essas tarefas justamente porque tinham falhado, e repetir tarefas que falharam parece melhor por acaso: regressão à média. Contra o controle, a flag ainda parece melhor, mas tratando as tentativas como independentes (o que favorece o resultado), as diferenças não são significativas: o p de Fisher exato é cerca de 0,24 para verificadas, 0,20 para passagens no juiz, 0,67 para erros de sanitizer e 0,04 para respostas repetidas (uma de cinco comparações abaixo de 0,05). Minha conclusão: uma pequena tendência positiva, não um efeito demonstrado. A flag só muda o feedback depois de uma falha de sanitizer, então é barato mantê-la ligada. Provar um efeito exigiria umas três vezes mais tentativas.
8. Erros que encontrei e retratei
- “O código
stackverificado estava correto.” Uma versão antiga do juiz nunca faziamallocoureallocfalharem. Depois que acrescentei casos de falha de alocação, nenhuma das tentativasstack“verificadas” antes sobreviveu (a causa mais comum eras->data = realloc(s->data, n)e um vazamento quando uma alocação posterior falhava). Um juiz que passa é um limite inferior. - “A Norma é o principal bloqueio; um script resolveria 40% das falhas.” Errado. A medição mostrou 2 de 123 tentativas. Retratei.
- Rótulos de dificuldade. Primeiro classifiquei as tarefas à mão e relatei 21% nas médias. Os lotes da própria escada dão 50%. Sempre use a definição que foi fixada antes da rodada.
- “O 7B tem o problema de funções demais do Haiku.” Uma suposição sobre a qual montei um experimento. O erro nunca aparece no código do 7B.
- “As três metas foram cumpridas” para a flag de sanitizer. Em boa parte, regressão à média, como o controle mostrou.
- “O thinking deixou o Sonnet caro.” A própria mensagem da API mostrou que o thinking já estava desligado. O que reduziu o custo foi
--effort low.
Também não está provado: a causa de um travamento que matou a primeira rodada do 7B. O servidor do modelo tinha iniciado com 4 slots e um cache de prompt de até 8 GiB numa máquina com 7,4 GiB de RAM. Corrigir com LLAMA_ARG_CACHE_RAM=0 LLAMA_ARG_N_PARALLEL=1 e fechar o navegador eliminou o travamento, mas mudei três coisas de uma vez, então o cache é a hipótese principal, não uma causa provada.
9. Limites destes resultados
- As tarefas são minhas e pequenas. Nada aqui mede código fora da escada.
- Os juízes são um limite inferior: passar no juiz não prova que o código está correto.
- Com 3 tentativas por tarefa, uma tarefa de diferença está dentro do ruído.
- A taxa na nuvem (21 de 21) é uma taxa só nos casos difíceis, porque essas 21 foram escolhidas como as falhas do 7B. O Sonnet resolveu
calcerleem uma tentativa de duas, e orledele variou entre rodadas antes (3 de 5, 2 de 5, 0 de 2). Leia “todas as 41” como “todas as 41 alcançadas uma vez”, não como confiabilidade. - A cascata foi rodada por um script em duas etapas; o modo
--escalatedo harness ainda tem um único modelo de nuvem. - Os modelos de nuvem rodam na temperatura própria deles, então não são uma comparação direta com as rodadas locais.
- Nenhum enunciado de exame da 42 nem código de projeto avaliado foi enviado a nenhuma API. Só tarefas que eu mesmo escrevi.
10. Próximos passos
Em ordem de valor esperado por hora (a primeira ideia que tive, mais tentativas por tarefa, está descartada pela rodada de 5 tentativas da seção 4):
- Procurar um modelo local melhor, de 8B ou menos, que caiba em cerca de 5 GB, e rodar a mesma escada.
- Mostrar os casos de teste do juiz no prompt e mudar o primeiro prompt. Todos os experimentos até agora mudaram só a mensagem de reparo.
- Mais amostras: temperatura de reparo, melhor de N.
- Um híbrido mais barato: o Haiku escreve um esqueleto, o modelo local escreve os corpos.
- Fine-tuning com soluções verificadas (precisa de GPU, centenas de tarefas e uma checagem dos termos dos provedores).
- Modelos locais maiores num desktop de 64 GB que estou planejando.
Para todo experimento novo: rodar um controle nas mesmas tarefas e escrever a meta de sucesso antes da rodada.
11. Como reproduzir
O código, os juízes, a escada e os logs estão no repositório c42-factory (harness.py, compare.py, exp.sh, cloud21.sh, ceiling.py, normkinds.py, e o ROADMAP_v9.md com todas as tabelas acima e o histórico completo). O controle de custo e os tetos de gasto fazem parte do harness, e a chave da API é lida só de uma variável de ambiente.